Donato Capitella
Benchmarks och uppsättningar för lokala AI-modeller
Techkolls omdöme
Kanalen handlar om att köra AI-språkmodeller lokalt på hårdvara från AMD och Intel. Videorna innehåller mätningar av hastighet och konfiguration för modeller som Qwen och DeepSeek, med inferensmotorer som llama.cpp och vLLM. Det finns även genomgångar av kvantisering och säkerhetsrisker i modellvikter. Flera videor är sponsrade av AMD.
Senaste videorna
Om videorna: bilderna hämtas från YouTube. När du startar en video laddas spelaren från Google, som då får din IP-adress och kan sätta kakor. Läs mer under Integritet. Omdömet är skrivet av Techkoll och har ingen koppling till YouTube.

 Intel Arc Pro B70: Qwen3.8 on One and Two GPUs with vLLM, llama.cpp and Strata
 My two cents on the DeepSeek ban in the US and model backdoors
 DeepSeek V4.1 Flash 1017 Update: 44% Fewer Tokens, Running on Strix / Gorgon Halo with DwarfStar
 Qwen3.8 27B and Flash Next on Single/Dual AMD Radeon 9700: Engine Benchmarks and Setup
 Thoughts on 2-Bit Quantization, IQ2_XXS, imatrix and antirez's DeepSeek quant
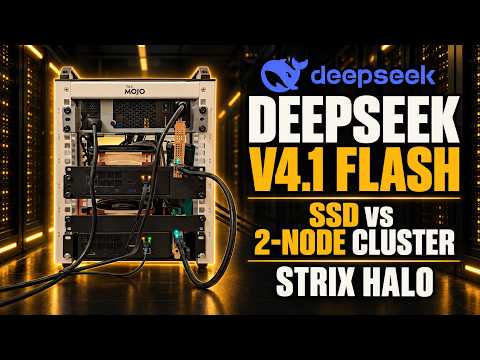 DeepSeek V4.1 Flash on Strix Halo: Single-Node SSD vs Two-Node Cluster (DwarfStar)
 Qwen3.8-Flash-Next on AMD Strix Halo: Halogen, N-grams and Benchmarks